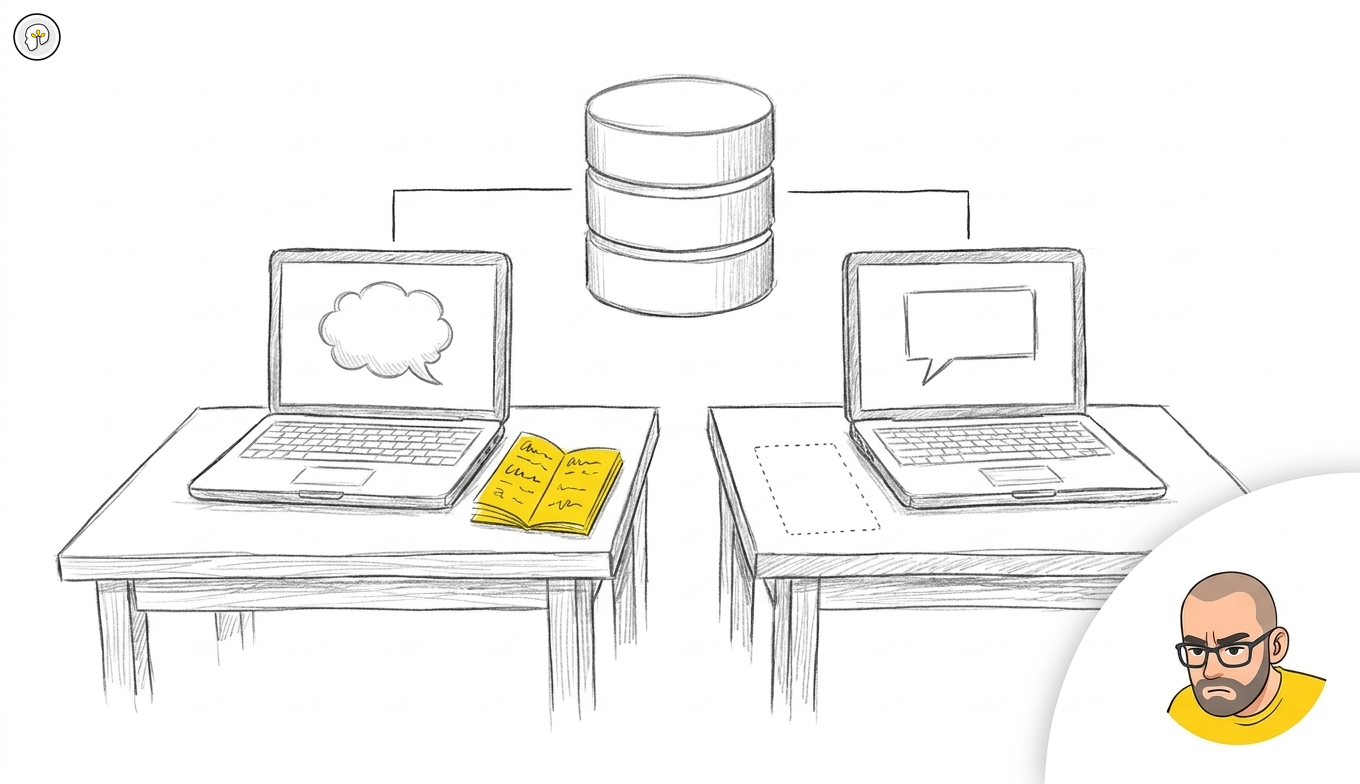
Två datorer, två svar
Jag jobbar på två datorer. Samma miljö, samma repon, samma datakälla. En dag ställde jag samma fråga på båda och fick två olika svar.
Inte olika formuleringar. Olika kunskap. Den ena kände till ett beslut jag hade fattat. Den andra hade ingen aning om att det fanns, och svarade precis lika säkert.
Min första reaktion var den de flesta har: modellen är inkonsekvent. Det har jag skrivit om tidigare, och det är ett verkligt problem. Men det var inte det som hände här. Båda maskinerna gjorde exakt det de är byggda för. De visste bara inte samma saker.
Var skillnaden satt
Claude Code har ett minne. Medan det arbetar skriver det små markdown-anteckningar när det lär sig något som är värt att behålla: en rättelse du gjort, en preferens, ett beslut om projektet. Anteckningarna läses in automatiskt när varje session startar, utan att någon ber om det.
De sparas inte i repot. De sparas i din hemkatalog:
~/.claude/projects/<projekt>/memory/
Dokumentationen är tydlig med vad det innebär. Minnet är lokalt för maskinen och delas inte mellan maskiner eller molnmiljöer ("Auto memory is machine-local. ... Files are not shared across machines or cloud environments.").
Mina två datorer var alltså aldrig samma miljö. Koden var identisk. Datan var identisk. Men lagret som formade svaren fanns bara på den ena maskinen.
Varför det är svårt att upptäcka
Tre egenskaper samverkar, och tillsammans gör de problemet nästan osynligt.
Minnet ligger aldrig i git. Inte i en commit, inte i en pull request, inte i en klon. Tre utvecklare i samma kodbas bygger tre separata minnen om den, och ingen av dem ser de andras.
En ny plats börjar tom. En andra dator, en nyinstallation, en molnsession: alla börjar utan något av det den första maskinen lärt sig. Ditt eget minne följer inte med dig.
Ingenting talar om att det skiljer. Det finns ingen varning som säger "det finns en rättelse om det här, men inte här". Svaret ser lika säkert ut i båda fallen.
Det sista är det egentliga problemet. Faran är inte att minnet saknas. Faran är att det saknas utan att det märks.
Git tar inte med det
Det är lätt att anta att om du och en kollega jobbar i samma repo, så delar ni också det verktyget vet om det. Det gör ni inte.
Ni kan ha identiska kloner, samma gren, samma commit, och ändå helt olika minnen. Allt Claude har lärt sig när det jobbat med dig stannar i din hemkatalog. Ingenting av det pushas, pullas eller klonas.
Tekniskt går det att flytta minnet med inställningen autoMemoryDirectory, och till och med peka in det i repot. I praktiken fungerar det inte som ett sätt att dela. Inställningen tar bara absoluta sökvägar, så det fungerar bara om alla har repot på exakt samma plats. Personliga anteckningar skulle hamna i en commit som alla kan läsa. Och när två personer skriver till samma minnesfiler blir det mergekonflikter i något som ingen granskar.
Den delade kanalen finns redan. Den heter CLAUDE.md, och den är byggd för precis det här.
Var du startar spelar roll
Den andra överraskningen är att minnet inte bara beror på vilken maskin du använder, utan också på var du startar sessionen.
Minnet sparas per projekt. Inuti ett git-repo är projektet själva repot: startar du Claude i app/ eller i app/services/api/ får du samma minne. Utanför ett git-repo blir mappen du startar i projektet.
Det blir en fälla för den som har flera repon i en gemensam överordnad mapp. Säg att du har ~/work/, som inte är ett repo, med ~/work/app/ och ~/work/site/ i, som är det. Startar du Claude i ~/work/ får du ett minne. Startar du i ~/work/app/ får du ett annat. Något Claude lärde sig i den första sessionen syns inte i den andra, på samma maskin, för samma person, om samma kod.
Jag hittade det här i min egen miljö. Jag brukar starta i den överordnade mappen, så det var där mina anteckningar hade samlats. En session som startats direkt i ett av reposen hade inte haft någon av dem.
Katalognamnen under ~/.claude/projects/ byggs utifrån sökvägen, så ett repo som klonas till en annan plats, eller flyttas, börjar med största sannolikhet också med ett tomt minne.
Tre saker avgör vilket minne du får:
- Vilken maskin du sitter på. Laptop, desktop och server har var sitt.
- Vilket repo du är i.
- Om du är utanför ett repo: vilken mapp du startade i.
En person på en maskin kan ha flera minnen. En person på två maskiner har det garanterat. Du ser alla med:
ls ~/.claude/projects/*/memory/
Kör kommandot på varje maskin du använder och jämför. Filerna som bara finns på ett ställe brukar förklara svaret som inte stämde.
Exemplet som fick mig att ta det på allvar
I en av mina miljöer fanns en minnesfil med en rättelse om hur en kollega ska omnämnas. Den skrevs i juli, efter att ett dokument hade fått det fel och rättats.
Rättelsen låg på en enda maskin i sju veckor. Arbete på den andra maskinen hade ingen tillgång till den och hade kunnat upprepa samma misstag, utan att något visade att en rättelse någonsin gjorts.
Det här är ingen personlig preferens. Det är ett faktum om teamet, och alla som skriver om projektet behöver det. Det hade hamnat på det enda stället där ingen annan kunde se det.
Det här är ingen bugg
Minnet gör det det är byggt för: kommer ihåg lokalt, i det tysta, utan ceremonier. För personliga saker är det precis rätt. Du ska inte behöva berätta för ditt verktyg varje morgon att du föredrar korta svar.
Problemet är vad mer som hamnar där. Enligt dokumentationen är minnet bland annat tänkt för projektkontext som inte går att utläsa ur koden, och för beslut. Det är just den sortens kunskap ett team behöver dela.
Frågan är alltså inte "hur synkar vi minnet". Den är: vad förlitar vi oss på minnet för, som aldrig borde ha legat där?
Regeln
Om en kollega, eller din andra dator, behöver veta det för att jobba i projektet, hör det inte hemma i minnet.
| Lägg det i repot | Går bra att lämna i minnet |
|---|---|
| Hur bygge och tester körs | Att du föredrar korta commit-meddelanden |
| Servrar, portar, miljöer, åtkomstvägar | Att du vill ha kortfattade svar |
| Varför en lösning valdes bort | Dina egna genvägar och alias |
| Namnkonventioner, granskningsregler, definitioner | Hur du själv gillar att arbeta |
| Fakta om teamet och domänen |
Det som committas delas, och det är den mekanismen du ska använda:
CLAUDE.mdi repots rot: instruktioner som varje klon läser. Det här är den riktiga platsen för gemensamma konventioner..claude/rules/och.claude/settings.json: regler, behörigheter och hooks, när du vill att de ska vara lika för alla..claude/skills/: gemensamma arbetssätt, versionshanterade som kod.- Vanlig dokumentation: driftrutiner, beslutslogg, konventioner.
En minnesfil kan hänvisa till dem. Den ska aldrig vara den enda kopian av något.
Det är samma argument som jag förde om regler i repot. Regler i git överlever ett verktygsbyte. De överlever också ett maskinbyte, en ny kollega och en ny klon. Minnet överlever inget av det.
Så gör jag nu
När Claude berättar något om ett projekt som jag inte sett nedskrivet utgår jag från att min andra maskin inte vet det, och inte heller någon annan. Jag flyttar det till CLAUDE.md.
När något rättas frågar jag var rättelsen hamnade. Om svaret är minnet, och det är ett faktum om projektet snarare än en personlig preferens, flyttar jag det till repot.
När svaren skiljer sig jämför jag CLAUDE.md först. Sedan kollar jag om den ena maskinen har ett minne som den andra saknar. Kommandot /memory öppnar mappen direkt. Hittills har det förklarat varje skillnad.
Jag läser mitt eget minne då och då. Första gången hittade jag porttilldelningar, serveradresser och åtkomstvägar där. Allt det är projektkunskap och hör hemma i projektets dokumentation. Inloggningsuppgifter hör varken hemma i minnet eller i repot. De hör hemma i ett ställe byggt för hemligheter.
Jag håller utkik efter fällan. Mycket av det som ligger i minnet känns personligt men är egentligen fakta om projektet: hur en kollegas namn stavas, vilket pronomen hen använder, vilken server som kör vad. Det är precis sådant som ställer till skada när det bara finns på ett ställe.
Frågor att ställa i teamet
Det här är öppna frågor, inte retoriska.
- Vad bär var och en av oss på i minnet som de andra borde ha? Titta i din egen
~/.claude/projects/*/memory/innan du svarar. - Är vi tillräckligt noga med
CLAUDE.md? Om gemensam kunskap bara kan ligga där måste filen underhållas lika medvetet som kod. - Vill vi ha minnet påslaget alls i gemensamma projekt? Det kan stängas av per projekt med
autoMemoryEnabled: false. Mer förutsägbart, till priset av att förklara saker igen. - Hur skulle vi märka när det går fel? I dag talar ingenting om att det skiljer. Den enda signalen är att två personer, eller två maskiner, råkar jämföra svar.
Var kunskapen faktiskt finns
Kunskap som bara finns på en maskin är inte kunskap som teamet har. Det är kunskap som den maskinen har.
Jag upptäckte det av en slump, på mina egna två datorer, utan att någon annan var inblandad. I ett team händer samma sak varje dag, och där är det mycket svårare att se. Svaret ser rätt ut. Det är bara inte samma svar som din kollega fick.
Skriv ner det där alla läser. Då slutar svaren bero på vilken maskin du råkar sitta vid.